약물감시(Pharmacovigilance) ADE 분류기
생의학 사전학습이 이상반응(ADE) 문장 스크리닝에 실제로 도움이 되는지 검증한 어블레이션 연구입니다. 도움은 되지만 그 폭은 크지 않았습니다. 결과를 측정하는 통계 프로토콜도 어떤 모델이 이기느냐만큼이나 중요했습니다.
한눈에 보기
- 분야: 생의학 NLP / 약물감시(pharmacovigilance)
- 역할: 개인 프로젝트 (수업과 무관한 독립 프로젝트), 2026년
- 기술 스택: Python, PyTorch, HuggingFace Transformers, scikit-learn, pandas, 쌍체 부트스트랩(자체 구현)
- 핵심 지표: PubMedBERT macro-F1 0.938 (정확도 0.959) vs. BERT 기준선 0.920; 차이 −0.012 (95% CI [−0.024, −0.003], 0 제외)
- 상태: 완료, 커밋된 아티팩트에서 분석 재현 가능, GPU 불필요
문제 / 배경
약물감시 팀은 방대한 증례 보고서와 임상 문서에서 이상반응(ADE)을 설명하는 문장을 찾아냅니다. 정보 추출이나 신호 집계보다 먼저 거치는 이진 스크리닝 단계입니다. ADE Corpus v2는 의학 증례 보고서에서 추출한 23,516개 문장으로 구성된 벤치마크 데이터셋이며 이 과제에 널리 쓰입니다. 이 코퍼스에는 세 가지 트랜스포머 인코더가 적용된 적이 있습니다. 일반 도메인 BERT 기준선, BioBERT(PubMed + PMC 추가 사전학습), PubMedBERT(PubMed에서 처음부터 사전학습, 도메인 전용 어휘 사용)입니다. 하지만 기존 비교 연구들은 훈련 실행 노이즈와 테스트셋 샘플링 노이즈를 거의 구분하지 않습니다. 실제 효과 크기(macro-F1 약 1퍼센트포인트) 수준에서 정직한 신뢰구간을 보고하는 경우도 드뭅니다. 이 프로젝트에서는 두 가지 노이즈 원인을 명시적으로 유지하는 재현 프로토콜을 설계해 두 가지 구체적인 질문에 답하고자 했습니다. 생의학 사전학습이 실제로 도움이 되는가, 그리고 처음부터 사전학습한 모델(PubMedBERT)이 추가 사전학습 모델(BioBERT)보다 우수한가?
접근 방식
ADE Corpus v2에 대해 구조적 어블레이션을 수행했습니다. 분할 전에 결정론적 중복 제거 단계를 적용해 동일 레이블의 중복 문장을 제거하고 충돌 레이블 그룹도 처리하도록 했습니다(이번 버전에는 해당 사례가 없었지만 정책은 준수했습니다). 그 결과 중복 행 2,621개를 제거해 20,895개 인스턴스를 확보했습니다. 층화 80/10/10 분할은 정수 인덱스로 커밋했습니다. 모든 모델이 동일한 데이터를 사용합니다.
세 인코더 각각에 공유된 이진 분류 헤드(풀링된 [CLS] 표현에 대한 선형 레이어, HuggingFace AutoModelForSequenceClassification 사용)를 파인튜닝했습니다.
백본마다 민감도가 다르기 때문에 단일 공유 학습률을 적용하면 암묵적인 불이익이 생깁니다.
그래서 모델별 3×3 검증 스윕을 실행해 각 모델의 최적 학습률을 선택했습니다.
BERT는 1e-4, 생의학 모델 두 가지는 모두 5e-5입니다.
어블레이션 자체는 각 모델을 해당 스윕 최적 학습률로 10개 랜덤 시드에 걸쳐 실행합니다.
실행별 지표와 원시 예측 배열은 디스크에 저장해 재학습 없이 모든 하위 분석을 재현할 수 있게 했습니다.
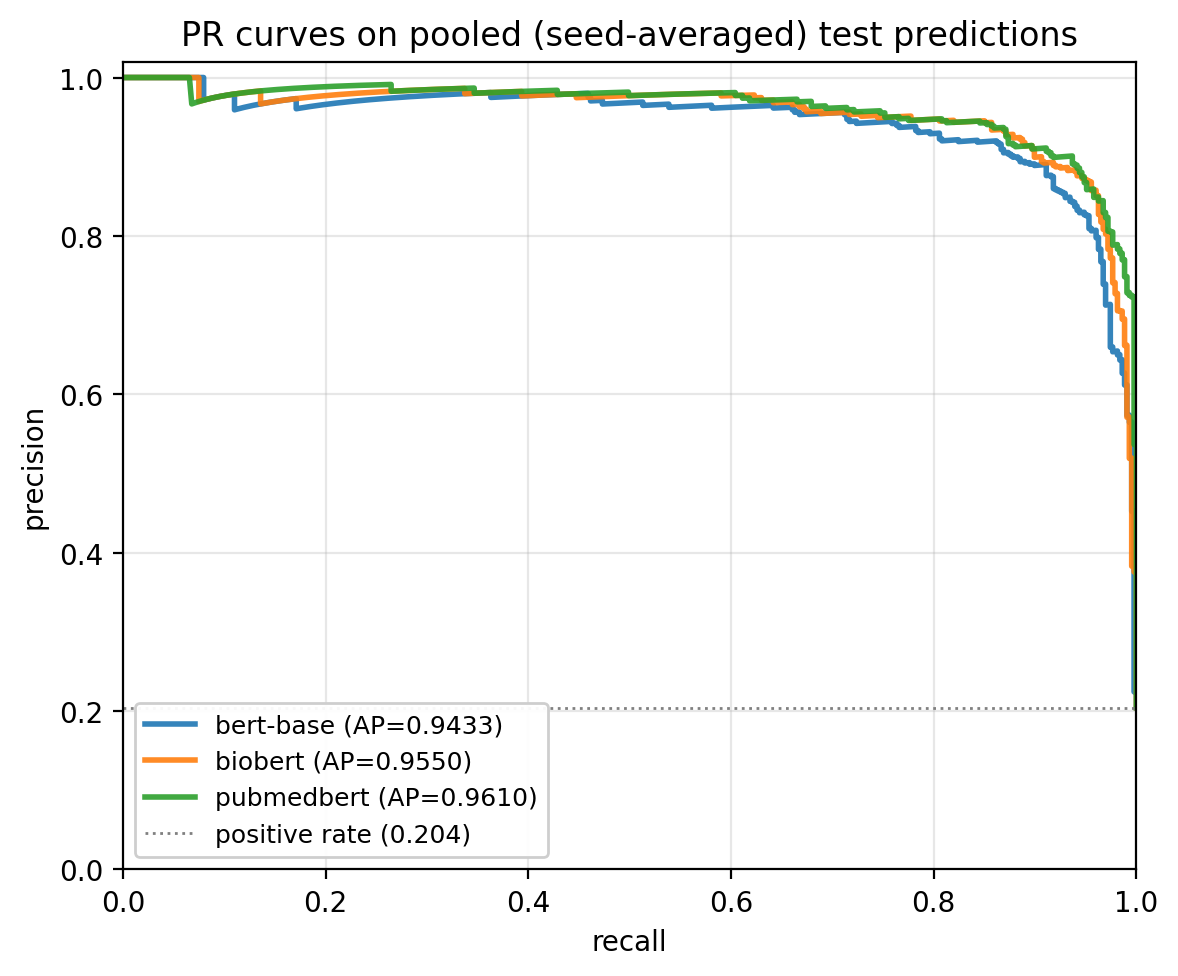
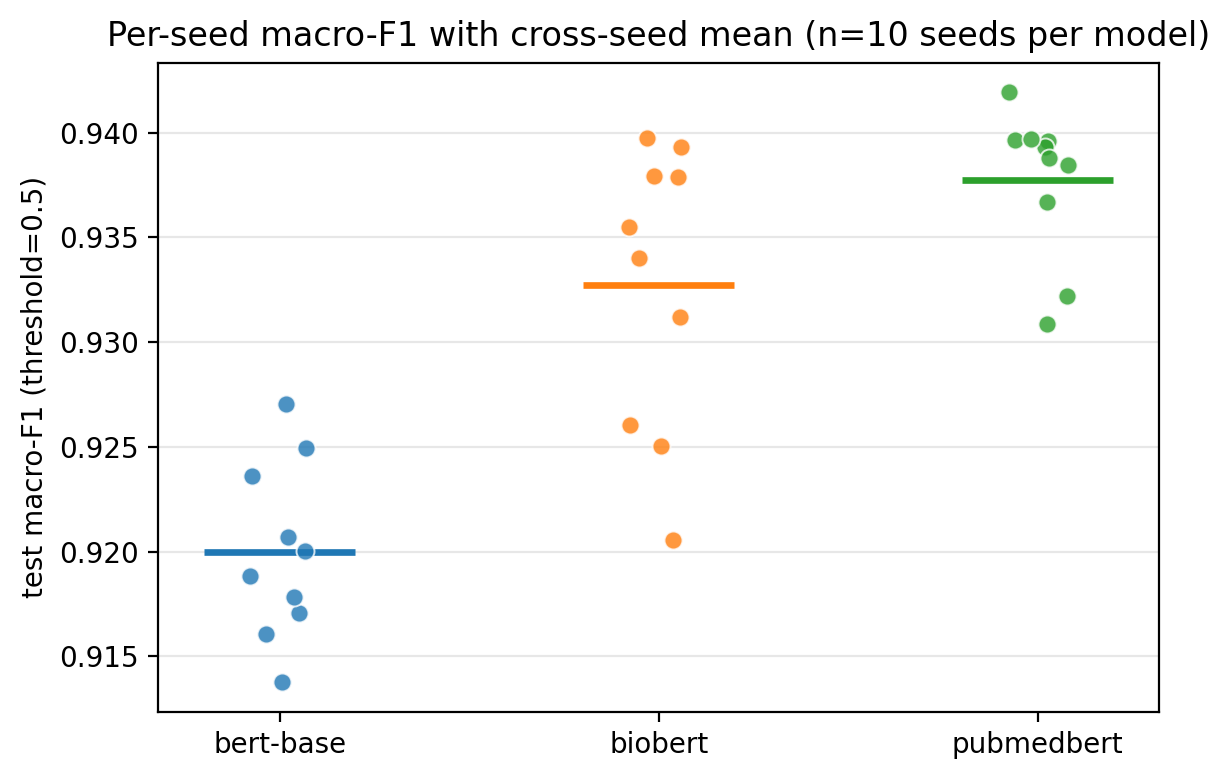
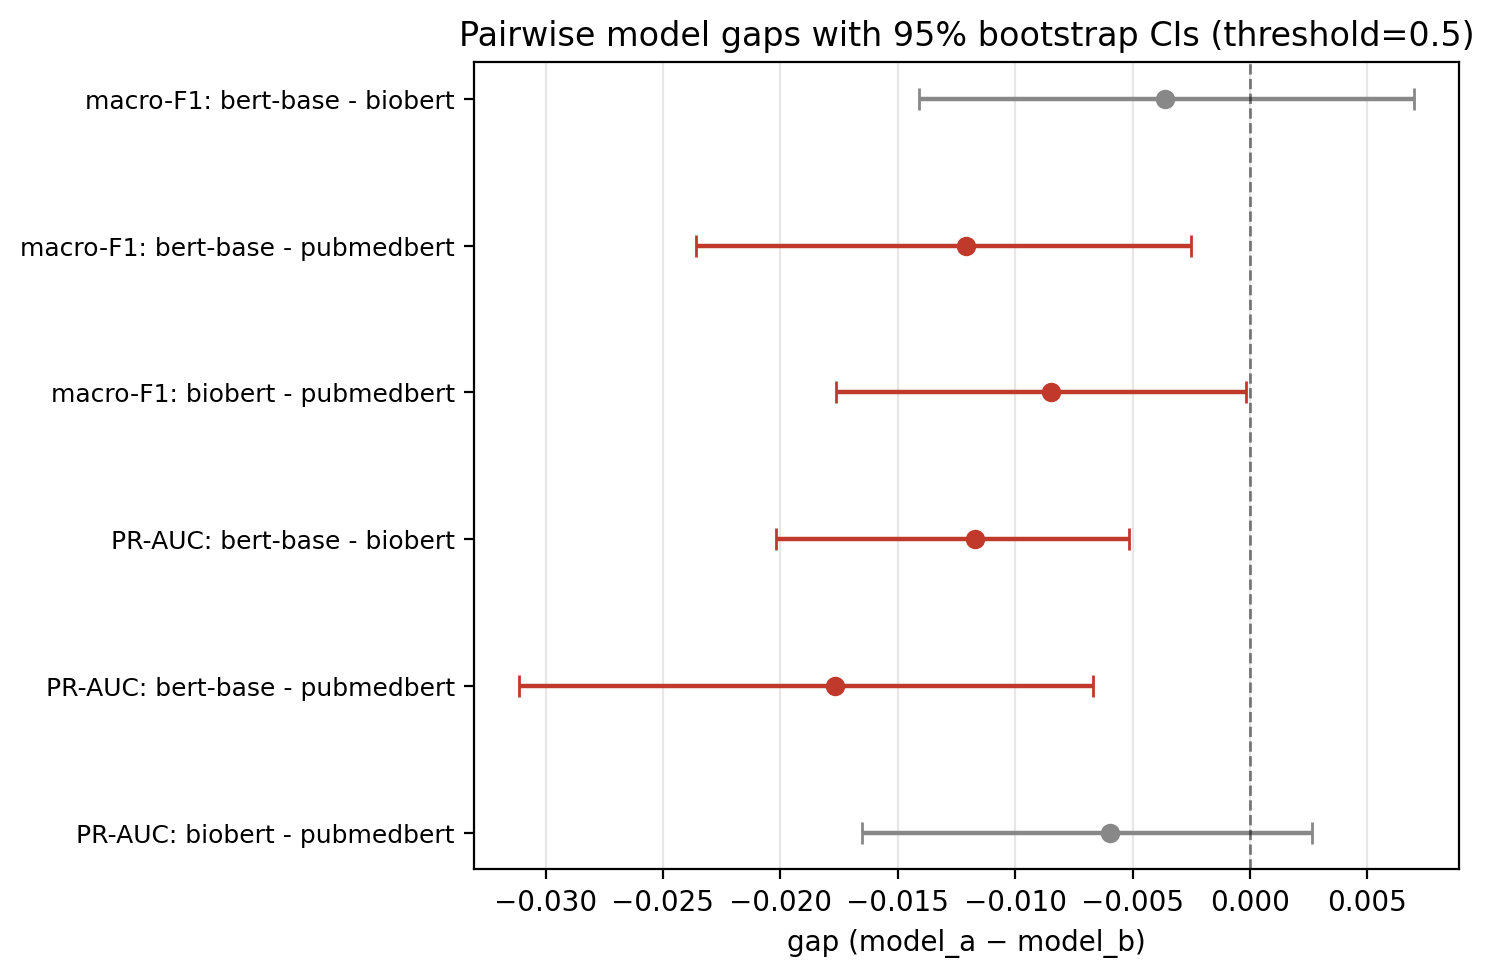
통계 쪽 핵심 결정으로 시드 분산과 테스트셋 샘플링 분산을 분리했습니다. 시드 간 표준편차(macro-F1 기준 0.003–0.007)로는 "훈련이 얼마나 안정적인가?"를 봅니다. 쌍체 부트스트랩(시드 평균 예측에 대한 1,000회 반복, 95% 백분위수 CI)으로는 "모델 간 차이가 실제인가, 아니면 테스트셋 운 때문인가?"를 판단합니다. 두 분산 원인을 분리해 한쪽 노이즈가 다른 쪽을 증폭하거나 가리는 일을 막았습니다. macro-F1과 함께 PR-AUC도 계산했습니다. 모델이 확률 순위(PR-AUC)를 개선하더라도 0.5 결정 경계(macro-F1)에서 판정한 성능은 개선하지 않을 수 있고, 이 둘을 혼동하면 생의학 사전학습이 실제로 무엇을 하는지 가려지기 때문입니다.
훈련은 Colab GPU에서 실행되었으며, 부트스트랩과 그래프 작업은 커밋된
results/ 아티팩트에서 로컬로 수 초 내에 실행됩니다.
전체 어블레이션은 커밋된 YAML 설정 파일 하나와 유닛 테스트로 실행됩니다. 덕분에 노트북에만 남아 있던 설정을 추측하지 않고도 30회 스윕(모델 3개 × 시드 10개)과 그 이후의 모든 그래프를 그대로 재현할 수 있습니다.
결과
argmax 임계값 0.5, 모델별 10개 시드의 테스트 지표 시드 간 평균:
| 모델 | 정확도 | macro-F1 | F1 (양성 클래스) | PR-AUC |
|---|---|---|---|---|
| bert-base-uncased | 0.9478 | 0.9200 | 0.8729 | 0.9432 |
| BioBERT | 0.9559 | 0.9327 | 0.8932 | 0.9549 |
| PubMedBERT | 0.9590 | 0.9377 | 0.9013 | 0.9608 |
쌍체 부트스트랩 신뢰구간 (쌍체, 1,000회 반복, 풀링된 테스트 예측에 대한 95% CI):
| 지표 | 비교 쌍 (a vs. b) | 차이 | 95% CI | 0 제외? |
|---|---|---|---|---|
| macro-F1 | bert-base vs. BioBERT | −0.0036 | [−0.0141, +0.0070] | 아니오 |
| macro-F1 | bert-base vs. PubMedBERT | −0.0121 | [−0.0236, −0.0025] | 예 |
| macro-F1 | BioBERT vs. PubMedBERT | −0.0085 | [−0.0176, −0.0002] | 예 |
| PR-AUC | bert-base vs. BioBERT | −0.0117 | [−0.0202, −0.0052] | 예 |
| PR-AUC | bert-base vs. PubMedBERT | −0.0177 | [−0.0311, −0.0067] | 예 |
| PR-AUC | BioBERT vs. PubMedBERT | −0.0060 | [−0.0165, +0.0026] | 아니오 |
결과 패턴: 생의학 계열 두 모델 모두 PR-AUC에서 BERT보다 높은 순위를 기록하며, 해당 신뢰구간은 0을 제외합니다. macro-F1에서는 PubMedBERT만 BERT 대비 명확히 구별 가능한 차이를 보이며, BioBERT의 macro-F1 향상은 확률 순위가 개선됨에도 불구하고 0.5 임계값에서 노이즈와 구분되지 않습니다.
주요 결정 사항 / 학습 내용
분할 전에 먼저 중복을 제거했습니다. 원본 코퍼스에는 완전히 동일한 텍스트가 2,621건 들어 있습니다. 분할한 뒤에 각각 제거하면 같은 문장이 훈련셋과 테스트셋에 동시에 들어갈 수 있습니다. 분할이 생기기 전에 전체에서 한 번에 제거해야 이 누출을 깔끔하게 막을 수 있습니다.
모델별로 학습률을 따로 고른 것도 실제로 중요했습니다. BERT의 스윕 최적값은 1e-4였고 두 생의학 모델은 모두 5e-5를 선호했습니다. 한 백본에 맞춘 학습률 하나를 공유했다면 나머지 모델이 조용히 불이익을 받았을 것입니다. 이 불이익은 최종 수치에는 드러나지 않지만 실험 설계상 분명히 존재하는 교란 요인입니다.
이번 연구에서는 시드 분산과 테스트셋 샘플링 분산을 분리한 결정이 가장 유용했습니다. 덕분에 BioBERT의 확률 순위는 BERT보다 나아지지만(구별 가능한 PR-AUC 차이) 0.5 임계값에서 내린 판정의 품질은 그렇지 않다는 점(노이즈와 구별되지 않는 macro-F1 차이)을 말할 수 있었습니다. 노이즈가 더 많은 평가 방식이었다면 이 차이는 아예 드러나지 않았을 것입니다.
솔직히 말하면 여기서 나온 효과 크기는 작습니다. macro-F1 기준 약 1퍼센트포인트 수준이고, 그것도 하나의 코퍼스에 있는 좁은 이진 과제 하나에 대한 결과입니다. 어블레이션이 보여주는 것 이상으로 부풀리는 헤드라인보다는 이렇게 있는 그대로 말하는 쪽을 택했습니다.
한계점
- 단일 테스트 분할. 모든 부트스트랩 CI는 2,090행의 단일 파티션 내의 분산을 정량화합니다. 교차 검증 또는 다중 분할 재현 실험은 테스트 샘플링 노이즈에 대한 더 완전한 시각을 제공할 것입니다.
- 단일 시드 하이퍼파라미터 스윕. 모델별 학습률은 단일 검증 실행(시드 13)에서 선택되었습니다. 더 엄밀한 프로토콜은 여러 시드에 걸쳐 스윕을 수행할 것이며, 본 연구는 낮은 비용으로 타당한 최적값을 선택하는 방식을 택했습니다.
- 과제 범위가 제한적입니다. 이진 문장 분류는 이 코퍼스에서 가장 단순한 ADE 과제입니다. 스팬 추출, 관계 연결, 임상 문서 스크리닝, 비영어권 텍스트에 대한 결과 적용은 별도 검증 없이는 불가능합니다.
- 외부 검증 없음. 모든 평가는 ADE Corpus v2 내에서 이루어졌습니다. FDA 이상반응 서술, 전자건강기록(EHR) 노트, 소셜미디어 약물감시 피드에 대한 일반화는 검증되지 않았습니다.
- 오류 분석 없음. 집계 지표만 보고되며, 각 모델이 어떤 유형의 문장을 오분류하는지에 대한 검토는 수행되지 않았습니다.
기술 스택
- 모델링: Python, PyTorch, HuggingFace Transformers (
AutoModelForSequenceClassification), BERT / BioBERT / PubMedBERT 체크포인트 - 데이터: HuggingFace Datasets를 통한 ADE Corpus v2
- 평가: scikit-learn (지표, 층화 분할), 자체 구현 쌍체 부트스트랩(NumPy)
- 분석 / 시각화: pandas, Matplotlib, Jupyter (분석 노트북은 로컬에서 GPU 없이 실행)
- 훈련: Google Colab (GPU); 이후 모든 분석은 커밋된 아티팩트에서 실행
링크
- GitHub: github.com/tysonjohnsondev/pharmacovigilance-ade-classifier
- 분석 노트북:
notebooks/analysis.ipynb, 커밋된 실행 결과에서 모든 그래프와 표를 약 10초 내에 재생성, 재학습 불필요 - 데이터셋: ADE Corpus v2 (Gurulingappa et al. 2012) via HuggingFace Datasets