CountryGuesser
단 한 장의 거리 뷰 사진만으로 촬영 국가를 예측하는 파인튜닝 이미지 분류기입니다. 동일한 1,000장 벤치마크에서 인간 비교군을 약 6배 차이로 앞섰습니다.
▶ 라이브 데모: tysonjohnson.dev/countryguesser에서 사람 대 모델 국가 맞추기 게임을 직접 플레이해 볼 수 있습니다.
한눈에 보기
- 분야: 컴퓨터 비전(이미지 지오로케이션, 국가 수준 분류, 180개 클래스)
- 역할: 5인 팀 과제 프로젝트의 기술 리드. 데이터 파이프라인·모델·웹 앱·통계 분석을 직접 맡았고, 팀원들은 케이스 스터디 참여자로도 참여했습니다
- 기술 스택: Python, PyTorch, EfficientNet-B0, OpenStreetView-5M (OSV-5M), Flask (gunicorn) 웹 앱
- 핵심 지표: 1,000장 웹 앱 벤치마크에서 Top-1 정확도 64.70% vs. 인간 평균 ~10.85% (McNemar χ²=444.7, p<0.001)
- 상태: 완료, 분석 노트북 2026년 4월 확정, 라이브 데모 배포 완료
문제 / 배경
거리 뷰 사진 한 장에도 실제 지리적 신호가 담겨 있습니다. 식생, 도로 표식, 간판 스타일, 지형 같은 단서입니다. 이를 국가 예측으로 바꾸는 것은 여전히 어려운 180개 클래스 분류 문제입니다. 무작위 기준선은 약 0.6%이고 열심히 하는 사람 플레이어조차 12%를 넘기기 어렵습니다. OpenStreetView-5M(OSV-5M)의 50만 장 서브셋으로 딥러닝 분류기를 만든 뒤, 구조화된 사람 대 모델 비교를 통해 모델이 어디서, 왜 실패하는지 찾아봤습니다.
접근 방식
OSV-5M에서 추출한 50만 장 이미지로 EfficientNet-B0 백본을 파인튜닝했으며 국가 수준 예측을 180개 클래스 분류 문제로 설정했습니다. EfficientNet-B0를 고른 이유는 정확도 대비 파라미터 수 비율이 좋기 때문입니다. 국가 수준의 시각적 단서(식생, 도로 표식, 간판 스타일, 지형)를 학습하기에 충분히 크면서도, 가용한 컴퓨팅 예산(Colab, A100 1대, 6 에폭) 안에서 훈련할 만큼 컴팩트합니다. 훈련은 배치 크기 32로 진행했고 실제 소요 시간은 약 4.7시간이었습니다.
정확한 진행 측정을 위해 홀드아웃 테스트 분할을 검증셋과 별도로 유지했습니다. 이전 체크포인트("구 모델")는 케이스 스터디 참여자를 모집할 당시 이미 웹 앱에 배포된 상태였으며, 최종 파인튜닝 체크포인트("신 모델")는 이후 동일한 1,000장 웹 앱 이미지에서 재채점하여 두 모델 평가 간 데이터 누출 없이 깔끔한 쌍체 비교를 구현했습니다.
사람 대 모델 분석을 위해 2026년 4월에 Python 노트북을 만들었습니다. 이 노트북은 1,000장 이미지에 대한 2,579개의 사람 응답과 두 모델의 예측을 함께 처리합니다. 쌍체 이진 결과에 적합한 McNemar 검정을 일관되게 적용해 이전 체크포인트 대비 새 체크포인트가 얼마나 개선됐는지 정량화했습니다. 이어서 신 모델과 사람 성능을 비교했습니다.
결과
| 벤치마크 | 정확도 |
|---|---|
| 무작위 기준선 (1/180) | ~0.6% |
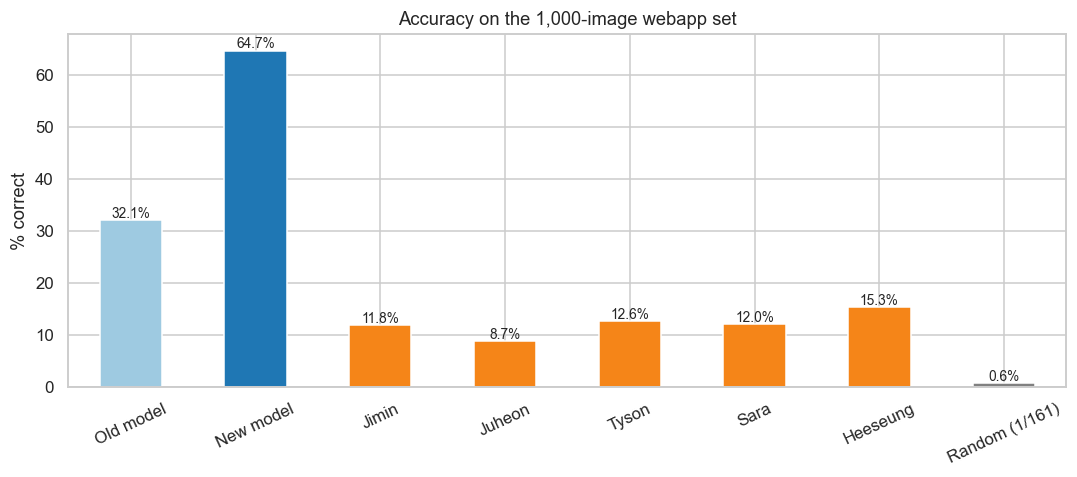
| 구 모델 체크포인트 (1,000장 웹 앱 세트) | 32.10% |
| 신 모델, 홀드아웃 테스트 분할 (일반) | 57.6% |
| 신 모델, 1,000장 웹 앱 벤치마크 | 64.70% |
| 검증 Top-1 | 75.0% |
| 인간 평균 (5인 케이스 스터디 집단) | ~10.85% |
신 모델 vs. 구 체크포인트: 동일한 1,000장 이미지에서 +32.6pp 향상 (McNemar χ²=272.5, p<0.001).
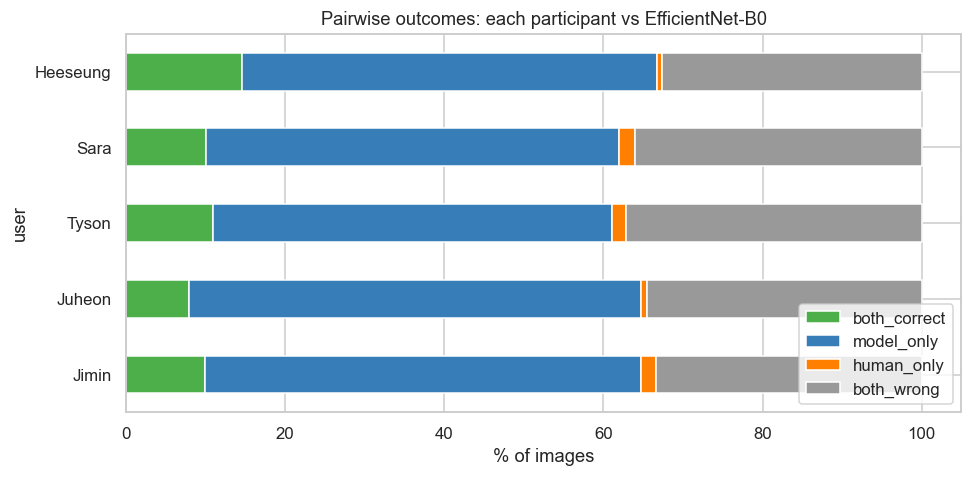
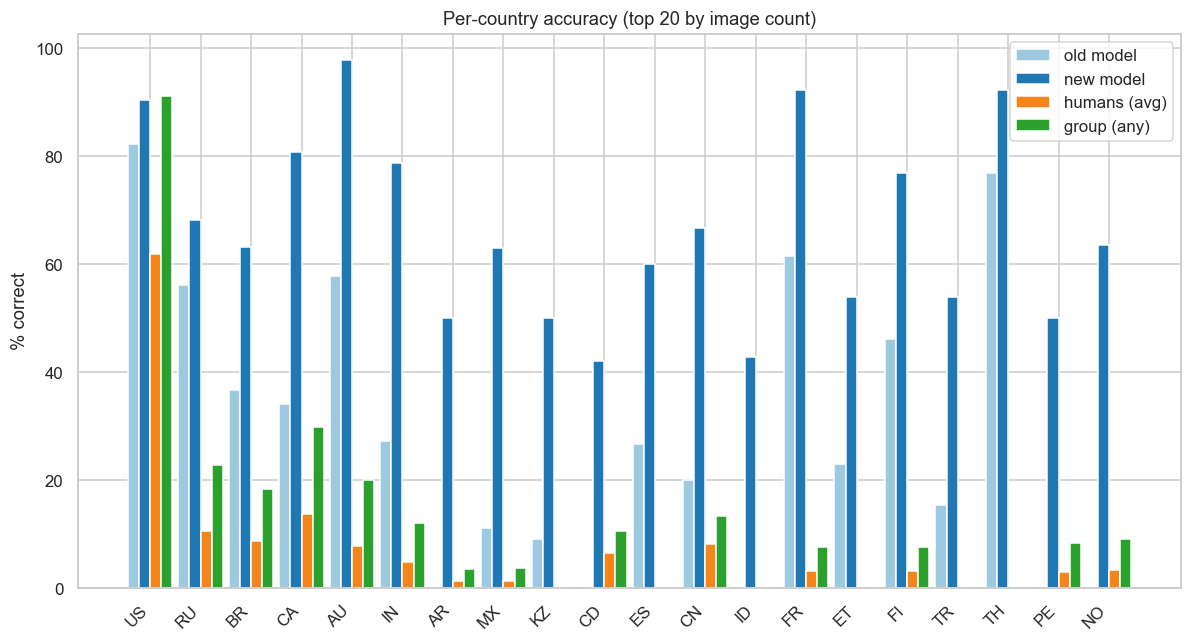
신 모델 vs. 사람: McNemar χ²=444.7, p<0.001 (임의의 사람이 정답인 경우 vs. 신 모델). 1,000장 세트에서 모델 정확도는 인간 평균의 약 6배입니다.
주요 결정 사항 / 학습 내용
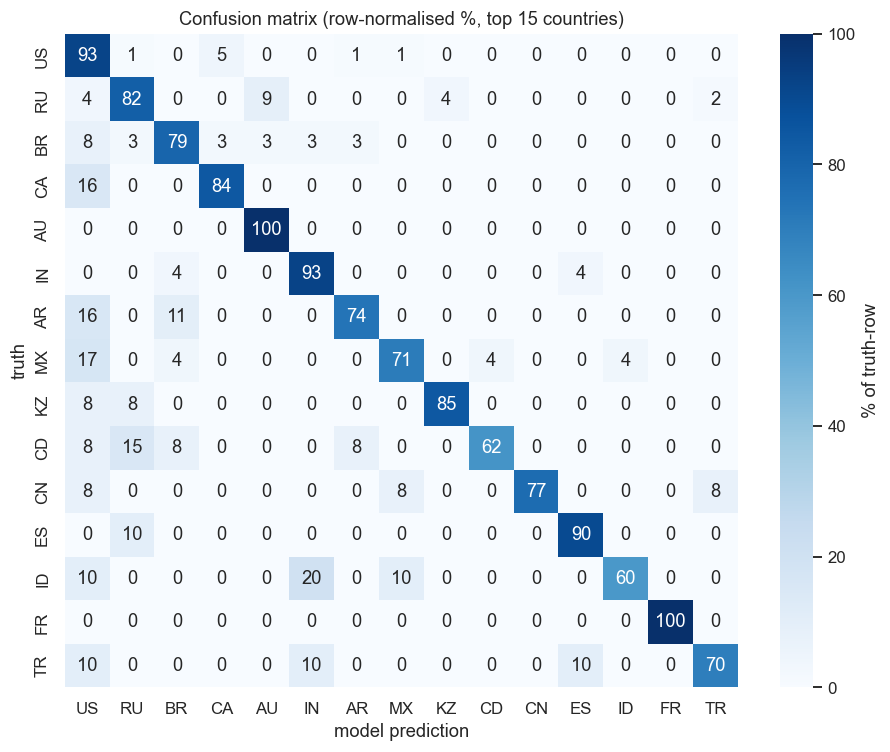
가장 뚜렷한 실패 패턴은 미국/캐나다 혼동입니다. 모델은 벤치마크에서 캐나다 이미지의 80.9%를 미국 또는 캐나다로 예측합니다. 사람이 모델을 이긴 22개 이미지 중 7개는 US↔Canada 오분류 사례입니다. 사람은 캐나다 특유의 단서(간판 폰트, 번호판 스타일)를 알아봤지만 모델은 북미 공통 시각 공간으로 뭉뚱그려버렸습니다. 모델이 지역 수준의 사전 지식은 학습했지만 시각적으로 유사한 인접 국가를 구분하는 세밀한 판별 특징은 놓친 것입니다.
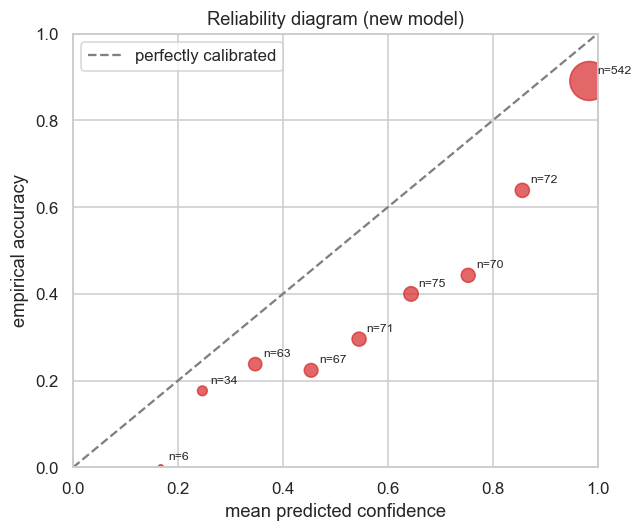
모델은 과신하기도 합니다. 그 정도는 정량적으로 측정했습니다. 가장 높은 신뢰도 구간(0.9~1.0, n=542 이미지)에서 실제 정확도는 약 89%인데 예측 평균 신뢰도는 약 98%입니다. 소프트맥스 분류기에서 흔히 나타나는 현상이지만 출력 점수를 의사결정 임계값으로 쓴다면 문제가 됩니다. 그래서 단순히 Top-1만 보고하지 않고 신뢰도 다이어그램을 따로 차트화했습니다.
사람과 모델은 우연보다 훨씬 자주 같은 이미지에서 틀립니다. 관찰된 사람만 정답인 경우는 독립 가정 하의 기댓값보다 훨씬 적습니다(지민: 관찰값 19 vs. 기댓값 41.7; 주헌: 관찰값 8 vs. 기댓값 30.7). 사람이 모델을 이기는 경우는 대부분 미국 정지 표지판이나 특정 번호판처럼 문화적 단서가 강한 이미지에서 나옵니다.
한계점
- 검증(75.0%)과 테스트(57.6%) 간 격차는 실제입니다. 약 17퍼센트포인트의 일반화 손실은 의미 있는 수치이며 OSV-5M 내부의 분포 이동을 반영할 가능성이 높습니다. 검증 분할과 테스트 분할이 국가별, 촬영 조건별로 동등하게 대표성을 갖지 않을 수 있습니다. 프로덕션 적합성을 주장하기 전에 국가별 이미지 수를 감사할 필요가 있습니다.
- 인간 코호트의 규모가 작습니다. 케이스 스터디 참여자 5인(각각 n=144~n=1,000개 응답)은 효과 크기를 고려할 때 통계적 유의성을 확보하기에 충분하지만, 더 많거나 지리적으로 다양한 플레이어 집단으로는 인간 평균이 달라질 수 있습니다.
- 과신(overconfidence)이 보정되지 않았습니다. 소프트맥스 출력은 보정되지 않은 상태입니다. 훈련 후 온도 스케일링(temperature scaling) 단계를 적용하면 신뢰도 다이어그램이 대각선에 가까워지고 신뢰도 점수의 신뢰성이 높아집니다.
- OSV-5M의 클래스 불균형. 데이터셋 내 거리 뷰 이미지가 적은 국가(예: CD, ET)는 모델 정확도가 현저히 낮습니다. 성능은 데이터가 풍부한 국가에 크게 치우쳐 있습니다(미국: ~90%, 호주: ~98%).
- 국가 수준은 거친 예측 목표입니다. 이미지로 국가를 예측하는 것은 흥미로운 벤치마크이지만, 실용적인 지오로케이션 사용 사례는 보통 더 세밀한 해상도를 요구합니다. 이 프로젝트는 도시 또는 좌표 수준의 예측을 다루지 않습니다.
- 웹 앱의 정답 드롭다운은 161개국만 나열합니다. 이 제한은 구 배포 모델에서 비롯된 레거시 제약이자 UI 아티팩트일 뿐 모델의 클래스 수가 아닙니다. 커밋된 모델은 훈련된 180개 국가 전체를 분류합니다. 실제로는 그 180개 중 120개만 1,000장 벤치마크에서 정답 레이블로 등장하며 훈련된 19개 국가는 사람이 응답으로 선택할 수 없습니다.
기술 스택
- 모델링: Python, PyTorch, EfficientNet-B0 (파인튜닝), torchvision
- 데이터: OpenStreetView-5M (OSV-5M), 50만 장 훈련 서브셋
- 분석: pandas, NumPy, matplotlib, seaborn, SciPy (McNemar 검정)
- 웹 앱 / 데이터 수집: Flask (gunicorn), Leaflet 지도 프론트엔드, SQLite 응답 로깅
- 환경: 훈련: Google Colab (NVIDIA A100); 라이브 데모: RackNerd VPS (Apache + Cloudflare)
링크
- 라이브 데모: tysonjohnson.dev/countryguesser
- GitHub: github.com/tysonjohnsondev/geolocation-project
- 분석 노트북:
human_vs_model_analysis.pdf(2026년 4월 14일), 요청 시 제공 - 데이터셋: OpenStreetView-5M